
-
 加我公众号(orasos)
 加我微信(17813235971)
 加我QQ(107644445)

标签云
asm恢复 bbed bootstrap$ dul kcbzib_kcrsds_1 kccpb_sanity_check_2 kcratr_nab_less_than_odr MySQL恢复 obet ORA-00312 ORA-00704 ORA-00742 ORA-01110 ORA-01200 ORA-01555 ORA-01578 ORA-01595 ORA-600 2662 ORA-600 2663 ORA-600 3020 ORA-600 4000 ORA-600 4137 ORA-600 4193 ORA-600 4194 ORA-600 16703 ORA-600 kcbzib_kcrsds_1 ORA-600 KCLCHKBLK_4 ORA-600 kcratr_nab_less_than_odr ORA-15042 ORA-15196 ORACLE 12C oracle dul ORACLE PATCH Oracle Recovery Tools oracle加密恢复 oracle勒索 oracle勒索恢复 oracle异常恢复 ORACLE恢复 Oracle 恢复 ORACLE数据库恢复 oracle碎片 OSD-04016 YOUR FILES ARE ENCRYPTED 比特币加密文章分类
- MongoDB (1)
- MongoDB恢复 (1)
- Others (2)
- 中间件 (2)
- WebLogic (2)
- 操作系统 (112)
- 数据库 (1,885)
- DB2 (22)
- MySQL (82)
- Oracle (1,710)
- Data Guard (53)
- EXADATA (8)
- GoldenGate (24)
- ORA-xxxxx (168)
- ORACLE 12C (72)
- ORACLE 18C (6)
- ORACLE 19C (15)
- ORACLE 21C (3)
- Oracle 23ai (8)
- Oracle ASM (73)
- Oracle Bug (8)
- Oracle RAC (56)
- Oracle 安全 (6)
- Oracle 开发 (28)
- Oracle 监听 (29)
- Oracle备份恢复 (663)
- Oracle安装升级 (108)
- Oracle性能优化 (62)
- 专题索引 (5)
- 勒索恢复 (91)
- PostgreSQL (37)
- pdu工具 (7)
- PostgreSQL恢复 (13)
- SQL Server (34)
- SQL Server恢复 (14)
- TimesTen (7)
- 达梦数据库 (5)
- 达梦恢复 (3)
- 生活娱乐 (2)
- 至理名言 (11)
- 虚拟化 (2)
- VMware (2)
- 软件开发 (51)
- Asp.Net (9)
- JavaScript (12)
- PHP (2)
- 小工具 (34)
- MongoDB (1)
-
最近发表
- 恢复案例分享:win丢失数据文件恢复
- 记录19c ASM磁盘掉线触发ORA-59048故障处理
- aix平台Oracle数据库由于断电无法启动故障处理
- 断电引起ORA-600 3005故障处理
- 记录一次云存储资源到期之后引起的数据库恢复
- Firebird 损坏数据库数据抢救工具—firebirdext
- Oracle 19c 202610补丁(RUs+OJVM)-19.33
- 由于con$.con#值达到极限,触发数据库增加约束报ORA-600 12807错误
- MongoDB 离线提取工具—mongoext
- .bres勒索病毒加密数据库dmp文件可恢复
- ORA-600 krsm_mrp_rebuild_lf_list.lno_mismatch
- 记录一次0丢失的ORA-00354: 损坏重做日志块标头故障恢复
- 不当数据库恢复操作导致一个月数据丢失
- obet快速修复oracle 位图损坏块
- 不太常见的10.2.0.1的oracle redo损坏恢复
- obet forcecopy功能抢救硬件故障中的数据文件
- kcratr_nab_less_than_odr和system坏块故障处理
- 通过obet 恢复system坏块,打开数据库
- obet dbv功能完整说明
- 分享一例运行在aix上的sap系统数据库恢复过程
分类目录归档:Oracle ASM
记录19c ASM磁盘掉线触发ORA-59048故障处理
在一套Oracle 19c RAC环境中有ocr/vote所在磁盘组有磁盘offline
ASMCMD> lsdg
State    Type    Rebal  Sector  Logical_Sector  Block       AU  Total_MB   Free_MB  Req_mir_free_MB  Usable_file_MB  Offline_disks  Voting_files  Name
MOUNTED  EXTERN  N         512             512   4096  4194304  24576000  19047940                0        19047940              0             N  DATA/
MOUNTED  EXTERN  N         512             512   4096  4194304   2500608   1043156                0         1043156              0             N  FRA/
MOUNTED  NORMAL  Y         512             512   4096  4194304    102400    101576            51200           25188              1             Y  SYSDG/
ASMCMD> lsdsk -G sysdg
Path

/dev/asm_ocr1
/dev/asm_ocr2

ASMCMD>
在sqlplus中查询具体信息
[grid@dbserver1 ~]$ sqlplus / as sysdba

SQL*Plus: Release 19.0.0.0.0 - Production on Fri Nov 6 19:31:39 2026
Version 19.16.0.0.0

Copyright (c) 1982, 2022, Oracle.  All rights reserved.


Connected to:
Oracle Database 19c Enterprise Edition Release 19.0.0.0.0 - Production
Version 19.16.0.0.0

SQL> col path for a40
SQL> set lines 150
SQL> select disk_number,MOUNT_STATUS,HEADER_STATUS,MODE_STATUS,STATE,CREATE_DATE,MOUNT_DATE,
   2 name,path from v$asm_disk where group_number=3;

DISK_NUMBER MOUNT_S HEADER_STATU MODE_ST STATE    CREATE_DA MOUNT_DAT NAME                  PATH
----------- ------- ------------ ------- -------- --------- --------- --------------------- -------------
          2 MISSING UNKNOWN      OFFLINE FORCING  07-SEP-22 22-OCT-26 _DROPPED_0002_SYSDG
          1 CACHED  MEMBER       ONLINE  NORMAL   07-SEP-22 22-OCT-26 SYSDG_0001           /dev/asm_ocr2
          0 CACHED  MEMBER       ONLINE  NORMAL   07-SEP-22 22-OCT-26 SYSDG_0000           /dev/asm_ocr1
这里显示被丢失的磁盘状态处于missing,而且state=FORCING,磁盘名字变为_DROPPED_0002_SYSDG,这里表现出来的是磁盘应该是不可访问,然后asm 自动踢掉该盘,但是没有正常清除元数据.查询磁盘reblance状态
SQL> SELECT GROUP_NUMBER, OPERATION, STATE, POWER, ERROR_CODE
  2      FROM GV$ASM_OPERATION
  3      WHERE GROUP_NUMBER = 3;

GROUP_NUMBER OPERA STAT      POWER ERROR_CODE
------------ ----- ---- ---------- --------------------------------------------
           3 REBAL WAIT          1
           3 REBAL ERRS          1 ORA-59048
           3 REBAL WAIT          1
           3 REBAL WAIT          1
           3 REBAL WAIT          1
           3 REBAL ERRS          1 ORA-59048
           3 REBAL WAIT          1
           3 REBAL WAIT          1
该磁盘组在reblance的过程中由于遭遇了ORA-59048导致无法清除掉异常磁盘元数据.关于ORA-59048的官方解释
SQL> !oerr ora 59048
59048, 0000, "Redundancy could not be restored in group '%0!s'."
// *Cause:  An attempt to restore redundancy during rebalance failed for some
//          user data or ASM metadata due to the presence of dropping or
//          forcing disks.
// *Action: Add back all the disks in DROPPING or FORCING state. If this is an
//          Oracle appliance, also add back all the missing disks.
出现该问题的原因是由于
In 12.1.0.2 ASM and higher releases, it is not allowed to Normal Drop the Failgroup in a Normal/High Redundancy Diskgroup if it lowers the Failgroup count below 3 for Normal Redundancy Diskgroup and below 5 for High Redundancy Diskgroup.Any attempt to force drop Failgroup will not expel the disks completely and leave the disks in “FORCING” state.
解决该问题官方的建议:
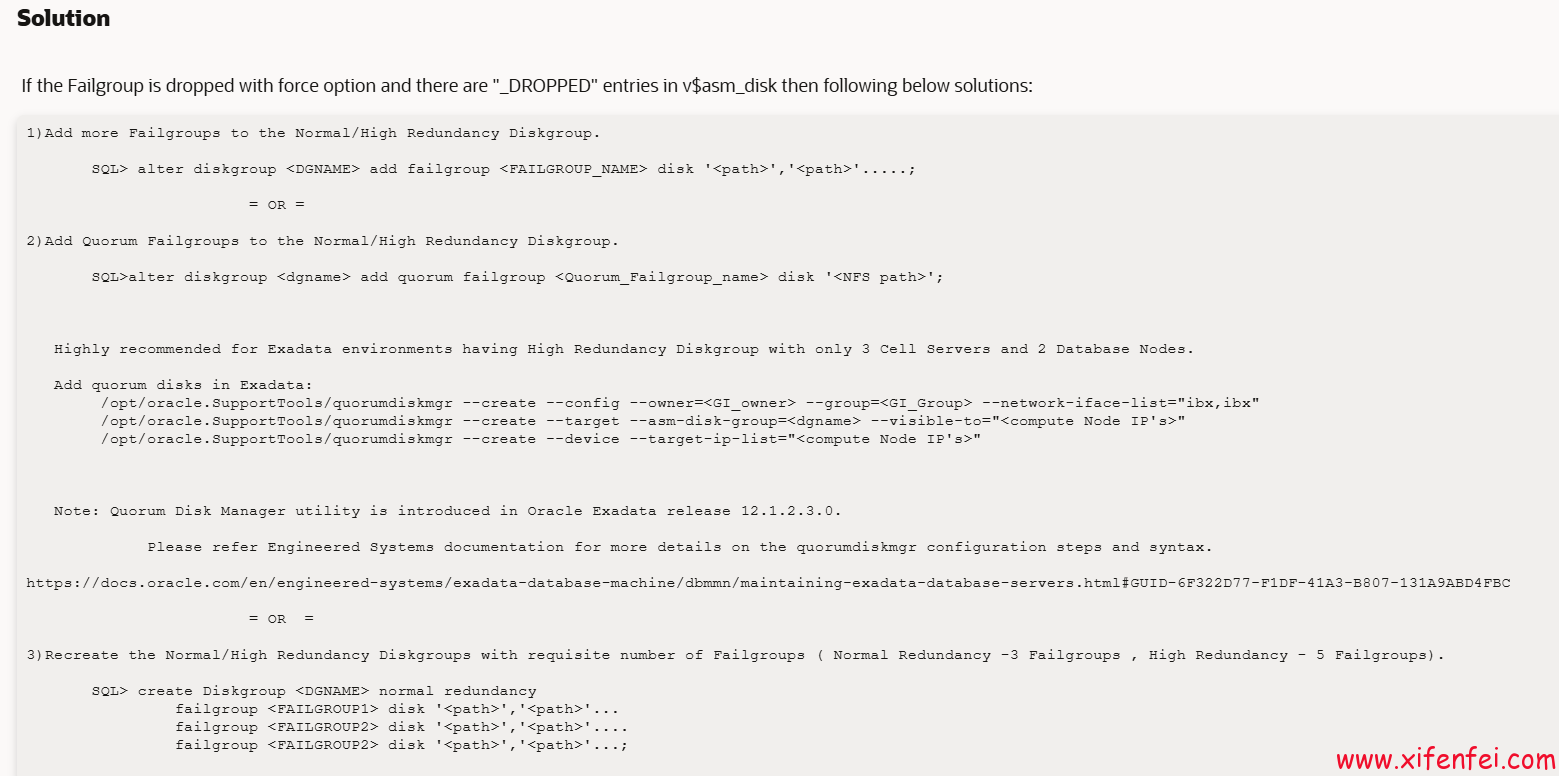
查看asm的alert日志确认该磁盘组当时具体状态,最早确实是由于/dev/asm_ocr3这个盘访问报io错误
2026-10-25T10:20:06.228405+08:00
NOTE: SMON did instance recovery for group FRA domain 2
NOTE: SMON detected lock domain 3 invalid at system inc 4 10/25/26 10:20:05
WARNING: Read Failed. group:3 disk:2 AU:0 offset:0 size:4096
path:/dev/asm_ocr3
	 incarnation:0xf0f3546f asynchronous result:'I/O error' ioreason:2818 why:11
	 subsys:System krq:0x7ffff294e3d8 bufp:0x7ffff2910000 osderr1:0x69b5 osderr2:0x0
	 IO elapsed time: 0 usec Time waited on I/O: 0 usec
NOTE: SMON starting instance recovery of group SYSDG domain 3 inc 4 (mounted) at 10/25/26 10:20:05
NOTE: 10/25/26 10:20:05 SYSDG.F1X0 found on disk 0 au 10 fcn 0.0 datfmt 1
NOTE: 10/25/26 10:20:05 SYSDG.F1X0 found on disk 1 au 10 fcn 0.0 datfmt 1
NOTE: SMON will attempt offline of disk 2 - no header
NOTE: cache initiating offline of disk 2 group SYSDG
NOTE: checking PST: grp = 3
2026-10-25T10:20:06.235215+08:00
GMON checking disk modes for group 3 at 20 for pid 23, osid 67867
2026-10-25T10:20:06.236213+08:00
NOTE: checking PST for grp 3 done.
NOTE: initiating PST update: grp 3 (SYSDG), dsk = 2/0xf0f3546f, mask = 0x6a, op = clear mandatory
2026-10-25T10:20:06.236627+08:00
GMON updating disk modes for group 3 at 21 for pid 23, osid 67867
cluster guid (11de9e990b017f7ebf235441d97d8d20) generated for PST Hbeat for instance 1
WARNING: Write Failed. group:3 disk:2 AU:1 offset:4190208 size:4096
path:/dev/asm_ocr3
	 incarnation:0xf0f3546f synchronous result:'I/O error' ioreason:13825 why:54
	 subsys:System krq:0x7ffff2606068 bufp:0x7ffff7e28000 osderr1:0x69c0 osderr2:0x0
	 IO elapsed time: 0 usec Time waited on I/O: 0 usec
WARNING: found another non-responsive disk 2.4042478703 (SYSDG_0002) that will be offlined
然后asm 自动踢掉该磁盘,并尝试进行reblance
2026-10-25T10:20:22.547474+08:00
NOTE: cache closing disk 2 of grp 3: SYSDG_0002
2026-10-25T10:20:22.555942+08:00
NOTE: cache closing disk 2 of grp 3: (not open) SYSDG_0002
2026-10-25T10:20:22.558591+08:00
NOTE: PST update grp = 3 completed successfully
2026-10-25T10:20:24.398958+08:00
Errors in file /u01/app/grid/diag/asm/+asm/+ASM1/trace/+ASM1_ora_24660.trc:
ORA-15078: ASM diskgroup was forcibly dismounted
2026-10-25T10:20:24.489753+08:00
NOTE: Attempting voting file refresh on diskgroup SYSDG
NOTE: Refresh completed on diskgroup SYSDG. Found 2 voting file(s).
NOTE: Voting file relocation is required in diskgroup SYSDG
NOTE: Attempting voting file relocation on diskgroup SYSDG
NOTE: Successful voting file relocation on diskgroup SYSDG
2026-10-25T10:20:24.970204+08:00
WARNING: Disk 2 (SYSDG_0002) in group 3 will be dropped in: (0) secs on ASM inst 1
NOTE: The rdbms compatibility of group SYSDG is 10.1.0.0.0
WARNING: PST-initiated drop of 1 disk(s) in group 3(.2297668793))
2026-10-25T10:20:24.977298+08:00
SQL> alter diskgroup SYSDG drop disk SYSDG_0002 force /* ASM SERVER */
2026-10-25T10:20:24.989168+08:00
NOTE: cache closing disk 2 of grp 3: (not open) SYSDG_0002
NOTE: GroupBlock outside rolling migration privileged region
2026-10-25T10:20:25.020909+08:00
NOTE: client +ASM1:+ASM:dbsvr-cluster no longer has group 1 (DATA) mounted
2026-10-25T10:20:25.028211+08:00
NOTE: requesting all-instance membership refresh for group=3
2026-10-25T10:20:25.033193+08:00
GMON updating for reconfiguration, group 3 at 32 for pid 47, osid 37477
2026-10-25T10:20:25.033508+08:00
NOTE: cache closing disk 2 of grp 3: (not open) SYSDG_0002
2026-10-25T10:20:25.036948+08:00
NOTE: group 3 PST updated.
2026-10-25T10:20:25.037055+08:00
NOTE: cache closing disk 2 of grp 3: (not open) SYSDG_0002
2026-10-25T10:20:25.138731+08:00
NOTE: membership refresh pending for group 3/0x88f3a4b9 (SYSDG)
NOTE: Attempting voting file refresh on diskgroup SYSDG
NOTE: Refresh completed on diskgroup SYSDG. Found 2 voting file(s).
NOTE: Voting file relocation is required in diskgroup SYSDG
NOTE: Attempting voting file relocation on diskgroup SYSDG
NOTE: Successful voting file relocation on diskgroup SYSDG
2026-10-25T10:20:25.243884+08:00
NOTE: cache closing disk 2 of grp 3: (not open) _DROPPED_0002_SYSDG
2026-10-25T10:20:25.244375+08:00
GMON querying group 3 at 33 for pid 26, osid 67882
2026-10-25T10:20:25.244593+08:00
NOTE: cache closing disk 2 of grp 3: (not open) _DROPPED_0002_SYSDG
2026-10-25T10:20:25.264523+08:00
SUCCESS: refreshed membership for 3/0x88f3a4b9 (SYSDG)
2026-10-25T10:20:25.265056+08:00
SUCCESS: alter diskgroup SYSDG drop disk SYSDG_0002 force /* ASM SERVER */
2026-10-25T10:20:25.267949+08:00
NOTE: starting rebalance of group 3/0x88f3a4b9 (SYSDG) at power 1
NOTE: starting process ARBA
Starting background process ARBA
2026-10-25T10:20:25.320353+08:00
ARBA started with pid=34, OS id=38626
NOTE: starting process ARB0
Starting background process ARB0
2026-10-25T10:20:25.348943+08:00
ARB0 started with pid=39, OS id=38628
NOTE: assigning ARBA to group 3/0x88f3a4b9 (SYSDG) to compute estimates
NOTE: assigning ARB0 to group 3/0x88f3a4b9 (SYSDG) with 1 parallel I/O
NOTE: starting priority rebalance
2026-10-25T10:20:25.741091+08:00
NOTE: 10/25/26 10:20:24 SYSDG.F1X0 copy 3 relocating from 2:10 to 65534:4294967294 at FCN 0.437476
NOTE: header on disk 0 advanced to format #2 using fcn 0.0
NOTE: F1B1 fcn on disk 0 synced at fcn 0.437476
NOTE: header on disk 1 advanced to format #2 using fcn 0.0
NOTE: F1B1 fcn on disk 1 synced at fcn 0.437476
2026-10-25T10:20:27.284097+08:00
NOTE: starting priority rebalance
NOTE: starting priority rebalance
NOTE: stopping process ARB0
NOTE: stopping process ARBA
NOTE: Attempting voting file refresh on diskgroup SYSDG
NOTE: Refresh completed on diskgroup SYSDG. Found 2 voting file(s).
NOTE: Starting expel slave for group 3/0x88f3a4b9 (SYSDG)
2026-10-25T10:20:27.638396+08:00
NOTE: GroupBlock outside rolling migration privileged region
NOTE: requesting all-instance membership refresh for group=3
2026-10-25T10:20:27.682346+08:00
GMON updating for reconfiguration, group 3 at 34 for pid 34, osid 38635
2026-10-25T10:20:27.682672+08:00
NOTE: cache closing disk 2 of grp 3: (not open) _DROPPED_0002_SYSDG
2026-10-25T10:20:27.686280+08:00
NOTE: group 3 PST updated.
2026-10-25T10:20:27.686317+08:00
NOTE: cache closing disk 2 of grp 3: (not open) _DROPPED_0002_SYSDG
SUCCESS: grp 3 disk _DROPPED_0002_SYSDG emptied
NOTE: grp 3 disk 2 not expelled because ASM metadata redundancy has
      not been restored due to an insufficientnumber of failure groups
比较简单的而且安全的做法是客户划分一块新的ocr盘上来,然后udev配置并加入到该磁盘组中即可.但是由于该客户存储没有新空间,只能分析尝试把原盘该加入进来.先确认该盘现在读写是否正常(存储故障已经修复)
1. kfed read 或者dd读取该盘确认正常
2. 由于该盘依旧属于sysdg磁盘组的member,无法直接加入
SQL> alter diskgroup sysdg add disk '/dev/asm_ocr3' ;
alter diskgroup sysdg add disk '/dev/asm_ocr3'
*
ERROR at line 1:
ORA-15032: not all alterations performed
ORA-15033: disk 'DATA01' is already part of diskgroup


SQL> ALTER DISKGROUP SYSDG ADD DISK '/dev/asm_ocr3'
2026-11-06T19:35:15.741021+08:00
NOTE: GroupBlock outside rolling migration privileged region
2026-11-06T19:35:15.909199+08:00
NOTE: cache closing disk 2 of grp 3: (not open) _DROPPED_0002_SYSDG
NOTE: Assigning number (3,3) to disk (/dev/asm_ocr3)
NOTE: requesting all-instance membership refresh for group=3
2026-11-06T19:35:15.998569+08:00
NOTE: membership refresh pending for group 3/0x88f3a4b9 (SYSDG)
2026-11-06T19:35:16.018117+08:00
NOTE: cache closing disk 2 of grp 3: (not open) _DROPPED_0002_SYSDG
2026-11-06T19:35:16.034067+08:00
GMON querying group 3 at 43 for pid 26, osid 67882
2026-11-06T19:35:16.035115+08:00
NOTE: cache closing disk 2 of grp 3: (not open) _DROPPED_0002_SYSDG
GMON querying group 3 at 44 for pid 26, osid 67882
2026-11-06T19:35:16.035967+08:00
NOTE: cache closing disk 2 of grp 3: (not open) _DROPPED_0002_SYSDG
2026-11-06T19:35:16.097552+08:00
NOTE: cache closing disk 2 of grp 3: (not open) _DROPPED_0002_SYSDG
GMON querying group 3 at 45 for pid 26, osid 67882
2026-11-06T19:35:16.098168+08:00
NOTE: cache closing disk 2 of grp 3: (not open) _DROPPED_0002_SYSDG
2026-11-06T19:35:16.119434+08:00
SUCCESS: refreshed membership for 3/0x88f3a4b9 (SYSDG)
2026-11-06T19:35:16.263264+08:00
ORA-15032: not all alterations performed
ORA-15033: disk '/dev/asm_ocr3' belongs to diskgroup "SYSDG"

2026-11-06T19:35:16.263630+08:00
ERROR: ALTER DISKGROUP SYSDG ADD DISK '/dev/asm_ocr3'
3. 直接使用force强制加入,也可以先dd掉磁盘头然后加入
SQL> ALTER DISKGROUP SYSDG ADD FAILGROUP SYSDG_0002 DISK '/dev/asm_ocr3' FORCE REBALANCE POWER 1;

Diskgroup altered.

SQL> SELECT GROUP_NUMBER, OPERATION, STATE, POWER, ERROR_CODE
  2      FROM GV$ASM_OPERATION
  3      WHERE GROUP_NUMBER = 3;

GROUP_NUMBER OPERA STAT      POWER ERROR_CODE
------------ ----- ---- ---------- --------------------------------------------
           3 REBAL REAP          1
           3 REBAL DONE          1
           3 REBAL DONE          1
           3 REBAL DONE          1
           3 REBAL WAIT          1
           3 REBAL WAIT          1
           3 REBAL WAIT          1
           3 REBAL WAIT          1

8 rows selected.

SQL> col path for a40
SQL> set lines 150
SQL> select disk_number,MOUNT_STATUS,HEADER_STATUS,MODE_STATUS,STATE,CREATE_DATE,MOUNT_DATE,
   2 name,path from v$asm_disk where group_number=3;

DISK_NUMBER MOUNT_S HEADER_STATU MODE_ST STATE    CREATE_DA MOUNT_DAT NAME         PATH
----------- ------- ------------ ------- -------- --------- --------- ------------ --------------
          1 CACHED  MEMBER       ONLINE  NORMAL   07-SEP-22 22-OCT-26 SYSDG_0001   /dev/asm_ocr2
          3 CACHED  MEMBER       ONLINE  NORMAL   06-NOV-26 06-NOV-26 SYSDG_0003   /dev/asm_ocr3
          0 CACHED  MEMBER       ONLINE  NORMAL   07-SEP-22 22-OCT-26 SYSDG_0000   /dev/asm_ocr1
磁盘成功加入,并且reblance完成,而且_DROPPED_0002_SYSDG磁盘记录也完全清除
[grid@dbserver1 ~]$ asmcmd
ASMCMD> lsdg
State    Type    Rebal  Sector  Logical_Sector  Block       AU  Total_MB   Free_MB  Req_mir_free_MB  Usable_file_MB  Offline_disks  Voting_files  Name
MOUNTED  EXTERN  N         512             512   4096  4194304  24576000  19047940                0        19047940              0             N  DATA/
MOUNTED  EXTERN  N         512             512   4096  4194304   2500608   1043156                0         1043156              0             N  FRA/
MOUNTED  NORMAL  N         512             512   4096  4194304    153600    152524            51200           50662              0             Y  SYSDG/
ASMCMD> lsdsk -G sysdg
Path
/dev/asm_ocr1
/dev/asm_ocr2
/dev/asm_ocr3
ASMCMD>
整个加入磁盘asm alert日志记录
2026-11-06T19:35:31.368323+08:00
SQL> ALTER DISKGROUP SYSDG ADD FAILGROUP SYSDG_0002 DISK '/dev/asm_ocr3' FORCE REBALANCE POWER 1
2026-11-06T19:35:31.369612+08:00
NOTE: GroupBlock outside rolling migration privileged region
2026-11-06T19:35:31.480932+08:00
NOTE: cache closing disk 2 of grp 3: (not open) _DROPPED_0002_SYSDG
NOTE: Assigning number (3,3) to disk (/dev/asm_ocr3)
NOTE: requesting all-instance membership refresh for group=3
NOTE: Disk 3 in group 3 is assigned fgnum=3
NOTE: discarding redo for group 3 disk 3
NOTE: initializing header (replicated) on grp 3 disk SYSDG_0003
NOTE: initializing header on grp 3 disk SYSDG_0003
NOTE: requesting all-instance disk validation for group=3
2026-11-06T19:35:31.544284+08:00
NOTE: skipping rediscovery for group 3/0x88f3a4b9 (SYSDG) on local instance.
2026-11-06T19:35:31.685931+08:00
NOTE: running client discovery for group 3 (reqid:9868412322975013714)
NOTE: requesting all-instance disk validation for group=3
2026-11-06T19:35:31.690689+08:00
NOTE: skipping rediscovery for group 3/0x88f3a4b9 (SYSDG) on local instance.
2026-11-06T19:35:31.798128+08:00
NOTE: running client discovery for group 3 (reqid:9868412322975027894)
NOTE: Allocated 1 DD reserve extents for group 3 (SYSDG)
NOTE: Allocated 2 VAT reserve extents for group 3 (SYSDG).
NOTE: Adding disk 3 (SYSDG_0003) to grp 3 (SYSDG) (12800 AUs)
2026-11-06T19:35:32.800462+08:00
GMON updating for reconfiguration, group 3 at 47 for pid 34, osid 32035
2026-11-06T19:35:32.800767+08:00
NOTE: cache closing disk 2 of grp 3: (not open) _DROPPED_0002_SYSDG
NOTE: group SYSDG: updated PST location: disks 0000 0001 0003
2026-11-06T19:35:32.806670+08:00
NOTE: cache closing disk 2 of grp 3: (not open) _DROPPED_0002_SYSDG
2026-11-06T19:35:32.806867+08:00
NOTE: group 3 PST updated.
2026-11-06T19:35:32.817316+08:00
NOTE: membership refresh pending for group 3/0x88f3a4b9 (SYSDG)
NOTE: Attempting voting file refresh on diskgroup SYSDG
NOTE: Refresh completed on diskgroup SYSDG. Found 2 voting file(s).
NOTE: Voting file relocation is required in diskgroup SYSDG
2026-11-06T19:35:32.870762+08:00
NOTE: cache closing disk 2 of grp 3: (not open) _DROPPED_0002_SYSDG
2026-11-06T19:35:32.871172+08:00
GMON querying group 3 at 48 for pid 26, osid 67882
2026-11-06T19:35:32.871938+08:00
NOTE: cache closing disk 2 of grp 3: (not open) _DROPPED_0002_SYSDG
NOTE: cache opening disk 3 of grp 3: SYSDG_0003 path:/dev/asm_ocr3
2026-11-06T19:35:33.135859+08:00
NOTE: Attempting voting file refresh on diskgroup SYSDG
NOTE: Refresh completed on diskgroup SYSDG. Found 2 voting file(s).
NOTE: Voting file relocation is required in diskgroup SYSDG
NOTE: Attempting voting file relocation on diskgroup SYSDG
NOTE: Failed voting file relocation on diskgroup SYSDG
2026-11-06T19:35:33.202862+08:00
NOTE: cache closing disk 2 of grp 3: (not open) _DROPPED_0002_SYSDG
2026-11-06T19:35:33.203321+08:00
GMON querying group 3 at 49 for pid 26, osid 67882
2026-11-06T19:35:33.203546+08:00
NOTE: cache closing disk 2 of grp 3: (not open) _DROPPED_0002_SYSDG
2026-11-06T19:35:33.248381+08:00
SUCCESS: refreshed membership for 3/0x88f3a4b9 (SYSDG)
2026-11-06T19:35:33.249044+08:00
SUCCESS: ALTER DISKGROUP SYSDG ADD FAILGROUP SYSDG_0002 DISK '/dev/asm_ocr3' FORCE REBALANCE POWER 1
2026-11-06T19:35:33.249626+08:00
NOTE: starting rebalance of group 3/0x88f3a4b9 (SYSDG) at power 1
NOTE: starting process ARBA
Starting background process ARBA
2026-11-06T19:35:33.300642+08:00
ARBA started with pid=39, OS id=32653
2026-11-06T19:35:33.300642+08:00
ARBA started with pid=39, OS id=32653
NOTE: starting process ARB0
Starting background process ARB0
2026-11-06T19:35:33.330349+08:00
ARB0 started with pid=40, OS id=32655
NOTE: assigning ARBA to group 3/0x88f3a4b9 (SYSDG) to compute estimates
NOTE: assigning ARB0 to group 3/0x88f3a4b9 (SYSDG) with 1 parallel I/O
NOTE: starting priority rebalance
2026-11-06T19:35:33.862973+08:00
NOTE: group 3, file 1, extent 0: successful reread of 256 block(s)
NOTE: group 3, file 1, extent 0: successful reread of 256 block(s)
NOTE: group 3, file 1, extent 0: successful reread of 256 block(s)
NOTE: group 3, file 1, extent 0: successful reread of 256 block(s)
NOTE: header on disk 3 advanced to format #2 using fcn 0.0
NOTE: F1X0 on disk 3 (fmt 2) relocated at fcn 0.442279: AU 0 -> AU 10
NOTE: 11/06/26 19:35:33 SYSDG.F1X0 copy 3 relocating from 65534:4294967294 to 3:10 at FCN 0.442279
NOTE: F1B1 fcn on disk 0 synced at fcn 0.442279
NOTE: F1B1 fcn on disk 1 synced at fcn 0.442279
…………
NOTE: group 3, file 121, extent 7: successful reread of 256 block(s)
NOTE: group 3, file 121, extent 7: successful reread of 256 block(s)
NOTE: group 3, file 255, extent 2147483648: successful reread of 256 block(s)
NOTE: group 3, file 255, extent 2147483648: successful reread of 256 block(s)
NOTE: group 3, file 255, extent 2147483648: successful reread of 256 block(s)
NOTE: group 3, file 255, extent 2147483648: successful reread of 256 block(s)
2026-11-06T19:35:43.100750+08:00
NOTE: starting priority rebalance
NOTE: Starting expel slave for group 3/0x88f3a4b9 (SYSDG)
2026-11-06T19:35:43.270964+08:00
NOTE: GroupBlock outside rolling migration privileged region
NOTE: requesting all-instance membership refresh for group=3
2026-11-06T19:35:43.373350+08:00
GMON updating for reconfiguration, group 3 at 50 for pid 45, osid 32714
2026-11-06T19:35:43.373665+08:00
NOTE: cache closing disk 2 of grp 3: (not open) _DROPPED_0002_SYSDG
2026-11-06T19:35:43.375552+08:00
NOTE: group 3 PST updated.
SUCCESS: grp 3 disk _DROPPED_0002_SYSDG emptied
NOTE: Expelling disk 2 (_DROPPED_0002_SYSDG) from grp 3 (SYSDG)
2026-11-06T19:35:43.414788+08:00
GMON updating for reconfiguration, group 3 at 51 for pid 45, osid 32714
2026-11-06T19:35:43.415757+08:00
NOTE: cache closing disk 2 of grp 3: (not open) _DROPPED_0002_SYSDG
2026-11-06T19:35:43.420906+08:00
NOTE: group 3 PST updated.
NOTE: grp 3 disk 2 expelled from the PST.
2026-11-06T19:35:43.528766+08:00
NOTE: membership refresh pending for group 3/0x88f3a4b9 (SYSDG)
2026-11-06T19:35:43.537768+08:00
GMON querying group 3 at 52 for pid 26, osid 67882
GMON querying group 3 at 53 for pid 26, osid 67882
2026-11-06T19:35:43.559379+08:00
NOTE: Disk _DROPPED_0002_SYSDG in mode 0x0 marked for de-assignment
SUCCESS: refreshed membership for 3/0x88f3a4b9 (SYSDG)
2026-11-06T19:35:44.127190+08:00
NOTE: starting priority rebalance
NOTE: stopping process ARB0
NOTE: stopping process ARBA
2026-11-06T19:35:44.568463+08:00
NOTE: Attempting voting file refresh on diskgroup SYSDG
NOTE: Refresh completed on diskgroup SYSDG. Found 3 voting file(s).
NOTE: Starting expel slave for group 3/0x88f3a4b9 (SYSDG)
2026-11-06T19:35:44.593489+08:00
NOTE: GroupBlock outside rolling migration privileged region
NOTE: requesting all-instance membership refresh for group=3
2026-11-06T19:35:44.607062+08:00
NOTE: membership refresh pending for group 3/0x88f3a4b9 (SYSDG)
2026-11-06T19:35:44.610642+08:00
GMON querying group 3 at 54 for pid 26, osid 67882
2026-11-06T19:35:44.654503+08:00
SUCCESS: refreshed membership for 3/0x88f3a4b9 (SYSDG)
2026-11-06T19:35:46.278541+08:00
SUCCESS: rebalance completed for group 3/0x88f3a4b9 (SYSDG)
NOTE: Attempting voting file refresh on diskgroup SYSDG
NOTE: Refresh completed on diskgroup SYSDG. Found 3 voting file(s).
dd破坏包含50多个pdb的asm 磁盘组恢复
前段时间刚刚恢复了一个客户dd了34个磁盘中的2个磁盘的1-2G多的数据(在生产环境错误执行dd命令破坏asm磁盘故障恢复),这次又遇到一个客户dd了asm 的两个磁盘的100m和10m,这次故障麻烦的是由于dd了disk 0和disk 1,ausize为4M,有50多个pdb在该磁盘组中,相对恢复比较麻烦,通过不懈努力,最后终于最大限度恢复客户数据,避免了进一步的损失
故障误操作
近期又一个可以误执行了dd命令,破坏了生产库的两个asm disk磁盘

上述截图中可以确认两个信息
1.sdh盘被dd掉了10m,sdg盘被dd掉了100M
2.sdg对应的是asm-data1,sdh对应的是asm-data2
dd误操作之后,data磁盘组开始报错,然后直接dismount.

分析原磁盘组中asm磁盘情况
1.确定损坏磁盘在磁盘组中位置
通过asm的alert日志分析损坏的盘对应的磁盘组信息

基于这个信息,我们可以确认asm-data1 对应的是DATA磁盘组的disk 0,asm-data2对应的是DATA磁盘组的disk 1,也就是说现在DATA磁盘组的0号盘被dd了100M,1号盘被dd了10m
2.确认ausize大小
通过分析该磁盘组的其他磁盘确认ausize大小
kfdhdb.ausize: 4194304 ; 0x0bc: 0×00400000
可以确认该磁盘组的au大小为4M
3.磁盘组后续进行了一次加盘扩容

在25年6月份,对data磁盘组加了三块盘
4.sdh(asm-data2)磁盘还被加入到了arch磁盘组中

比较幸运由于在另外一个节点上sdh磁盘权限没有正确修改,导致该增加没有完全成功,也就是该磁盘没有被reblance(如果加入成功并正常reblance,那后果比现在严重很多)
5.通过结合asm日志以及kfed,磁盘物理大小等信息,并且通过kfed构造出来损坏的磁盘头信息,列出故障之前DATA磁盘组所有磁盘的情况(为了避免udev别名带来的影响,我直接使用物理磁盘名称来显示)

客户现场情况说明
1.客户有一个大概1年多之前的dataguard(后续没有继续同步),已经进行了failover激活
2.客户的备份系统中有一个大概1个月之前的备份,但是备份库缺少归档,我接手之时,已经被维护厂商强制拉起
3.在我恢复之前,有专业的工程师已经对其这个现场进行了分析,但是没有拿出好的恢复方案
恢复难点说明
1.该磁盘组的disk 0 被dd掉了100M,这个导致kfdhdb.f1b1locn记录被清空,也就无法获取到存储指向ASM file 1 文件目录表,这个值虽然被清空,但是根据经验或者对比其他磁盘组的disk 0 可以确认指定aun为10
2.f1b1locn指向的au中存储中asm元数据1-255以及256-1023的file的前面60个au的extent映射表,由于这个在aun为10(也就是aun*aus=40M)的位置,但是这个位置也已经被dd掉了,从原理上业务文件256-1023的前面60个au的extent映射表彻底丢失
3.通过工具扫描,发现存储别名信息的au也在disk 0的前面100M之内(也被dd掉了),导致通过别名直接定位文件的起点的恢复思路也不可行,而且别名丢失导致以别名的数据文件后续识别有一定的难度(无法获取asm里面文件的完整路径)
4.该库有50多套pdb组成,也就意味着通过数据库碎片扫描的方式无法恢复(因为每个pdb里面都是由默认的种子创建而成,也就意味着rfile 1,4,9是重复的)
5.由于中途加过一次磁盘,因引起这个asm里面的文件进行重新reblance,使得部分文件同一个block记录在不同磁盘的au上(数据文件块可能重复)
6.由于该磁盘组中asm disk 大小不等,导致文件au分布在各个磁盘上不均匀,无明显规律可循
恢复操作
1.通过kfed对损坏的asm-data1、asm-disk2的磁盘头进行构造,便于后续的恢复工具识别
2.通过工具对data中所有磁盘进行扫描,主要扫描文件extent映射表信息和ACD中关于asm文件的分配信息
2.1> 通过对这些信息进行综合分析,确认asm file >=1024的文件的extent映射表信息完整,数据可以直接恢复,效果类似

2.2> 对于256-1023号文件通过asm file的extent信息缺少0-59 au的数据,结合acd中获取的部分au分配信息,可以尽可能完整的恢复出来这些数据(由于disk 0中的acd信息丢失,所以不是100%完整)

3.对于绝对文件号非1,4,9的文件,而且asm file 小于1024的数据文件,结合rdba碎片重组的方式再一次进行恢复,避免上面2.2中恢复中前面240M(60个au),有部分au信息丢失导致文件不完整的情况
通过上述多种方法恢复,整体恢复数据文件类似(由于文件较多,存放多个目录和根据规则取了多种名字)

4.由于asm的文件目录,别名信息全部丢失,而且该库有50多个pdb,无法确认恢复出来的上千个文件和pdb对应的关系,对于这种情况,临时写了一个小程序,对这些文件进行读取,获取file#,rfile#,ts#,tsname,文件大小,dbid,dbname,scn等信息(obet(Oracle Block Editor Tool)第二版发布

通过把这些信息和历史的控制文件中的信息进行匹配,确认各个文件所属的pdb关系
5.通过4中获取的文件和pdb对应关系然后通过dbms_pdb.recover包实现把恢复的文件插入到新的cdb库中,在这个插入和open库过程中遇到各种错误,都一一解决


6.最终完成客户数据恢复要求(为了保证数据不被再次修改,客户要求所有恢复的pdb不能打开到读写模式)

然后由客户的运维厂商或者应用厂商把需要的数据迁移或者整合到新库中并恢复业务,完成本次恢复任务
WARNING: detected duplicate paths to the same disk导致crs无法正常启动故障解决
最近一周之内,两个客户由于错误修改asm_diskstring=’/dev/dm*’,’/dev/mapper/*’,导致后续集群无法启动成功,查看asm的alert日志发现类似错误(为了说明类似问题,实际中情况比现在复杂)
WARNING: detected duplicate paths to the same disk:
  '/dev/mapper/mpathi' and
  '/dev/dm-3'
ERROR: diskgroup CRS was not mounted
ORA-15032: not all alterations performed
ORA-15017: diskgroup "CRS" cannot be mounted
ORA-15040: diskgroup is incomplete
由于asm的vote磁盘组无法mount,从而使得crs无法正常启动,进而导致集群无法正常启动和工作.而在系统中mpathi和dm-3是同一块磁盘
[root@rac1 mapper]# ls -ltr mpathi
lrwxrwxrwx 1 root root       7 May 24 13:09 mpathi -> ../dm-3
GPnP profile中关于asm_diskstring配置
[grid@rac1 trace]$  gpnptool get -o-
……
<orcl:ASM-Profile id="asm" DiscoveryString="/dev/dm*,/dev/mapper/mpath*"
SPFile="+DATA/cimp-cluster/asmparameterfile/registry.253.889969697"/>
……
对于这样的情况,需要把profile中值修改了才行,通过重建asm spfile来实现
---pfile
large_pool_size= 12M
instance_type= 'asm'
remote_login_passwordfile= 'EXCLUSIVE'
asm_diskstring= '/dev/mapper/*'
asm_power_limit= 1
diagnostic_dest= '/opt/app/grid'
创建spfile(create spfile=’+CRS’ from pfile=’/tmp/pfile’)
NOTE: Attempting voting file refresh on diskgroup CRS
NOTE: Refresh completed on diskgroup CRS. No voting file found.
NOTE: Voting file relocation is required in diskgroup CRS
NOTE: Attempting voting file relocation on diskgroup CRS
NOTE: voting file deletion on grp 1 disk CRS_0000
NOTE: voting file deletion on grp 1 disk CRS_0001
NOTE: voting file deletion on grp 1 disk CRS_0002
NOTE: No voting file found on diskgroup CRS
Sun May 24 13:23:25 2026
NOTE: updated gpnp profile ASM SPFILE to
NOTE: updated gpnp profile ASM diskstring: /dev/mapper/*
NOTE: updated gpnp profile ASM diskstring: /dev/mapper/*
NOTE: updated gpnp profile ASM SPFILE to +CRS/cluster/asmparameterfile/registry.253.1234099407
主要注意在create spfile的过程中voting file的信息被删除,使用kfed进行验证
[root@rac1 dbs]# kfed read /dev/asm_mpathi|grep vf
kfdhdb.vfstart:                       0 ; 0x0ec: 0x00000000
kfdhdb.vfend:                         0 ; 0x0f0: 0x00000000
[root@rac1 dbs]# kfed read /dev/asm_mpatha|grep vf
kfdhdb.vfstart:                       0 ; 0x0ec: 0x00000000
kfdhdb.vfend:                         0 ; 0x0f0: 0x00000000
[root@rac1 dbs]# kfed read /dev/asm_mpathd|grep vf
kfdhdb.vfstart:                       0 ; 0x0ec: 0x00000000
kfdhdb.vfend:                         0 ; 0x0f0: 0x00000000
需要执行replace votedisk
[root@rac1 dbs]# crsctl replace votedisk +CRS
Successful addition of voting disk 99df870869c64f78bf944b40bfff8644.
Successful addition of voting disk e6db086a74d64f49bf0aff02944bcac5.
Successful addition of voting disk e88a412fe04b4fe6bf1ca067bca779b8.
Successful deletion of voting disk 615579e778684f54bf31c0ce83709f37.
Successful deletion of voting disk 9e48b89f95084fefbfb7648897508684.
Successful deletion of voting disk 274b913b3b874f7cbfb6b025028b4eaa.
Successfully replaced voting disk group with +CRS.
CRS-4266: Voting file(s) successfully replaced
这样操作完成之后,再次查看GPnP profile中关于asm_diskstring配置
[grid@rac1 trace]$  gpnptool get -o-
……
<orcl:ASM-Profile id="asm" DiscoveryString="/dev/asm_*"
SPFile="+DATA/cimp-cluster/asmparameterfile/registry.253.1234099407"/>
……
然后再次重启集群,一切恢复正常,解决了asm_diskstring=’/dev/dm*’,’/dev/mapper/*’误操作引起的WARNING: detected duplicate paths to the same disk:故障
发表在 Oracle ASM, Oracle RAC
评论关闭
